
Écrire un script Python pour récupérer 100 pages est une tâche simple. Il s'exécute en local, se termine en quelques secondes et enregistre les données dans un simple fichier CSV.
Appliquer cette même logique à l'extraction de données de millions de pages crée une réalité complètement différente.
La vitesse, le coût et la fiabilité deviennent immédiatement des obstacles majeurs. Un script parfaitement fonctionnel pour de petits lots risque de planter, d'être bloqué ou de manquer de mémoire lorsqu'il est utilisé pour l'extraction de données web à grande échelle.
La mise à l'échelle ne se résume pas à allonger la durée d'exécution d'une boucle. Elle exige une transformation fondamentale de la conception de vos systèmes de collecte de données.
Nous détaillerons l'architecture précise nécessaire au web scraping en entreprise. Nous verrons pourquoi les threads locaux échouent, comment gérer la bande passante et pourquoi l'utilisation de Decodo pour des proxys à concurrence illimitée résout le principal goulot d'étranglement du secteur.
Le mythe de la concurrence : pourquoi les threads locaux échouent dans le web scraping à grande échelle
Une idée fausse courante concernant l'infrastructure de web scraping est liée au multithreading. Les développeurs pensent souvent qu'ajouter simplement des threads à un script Python résoudra les problèmes de vitesse. Bien que le multithreading soit utile, il a ses limites.
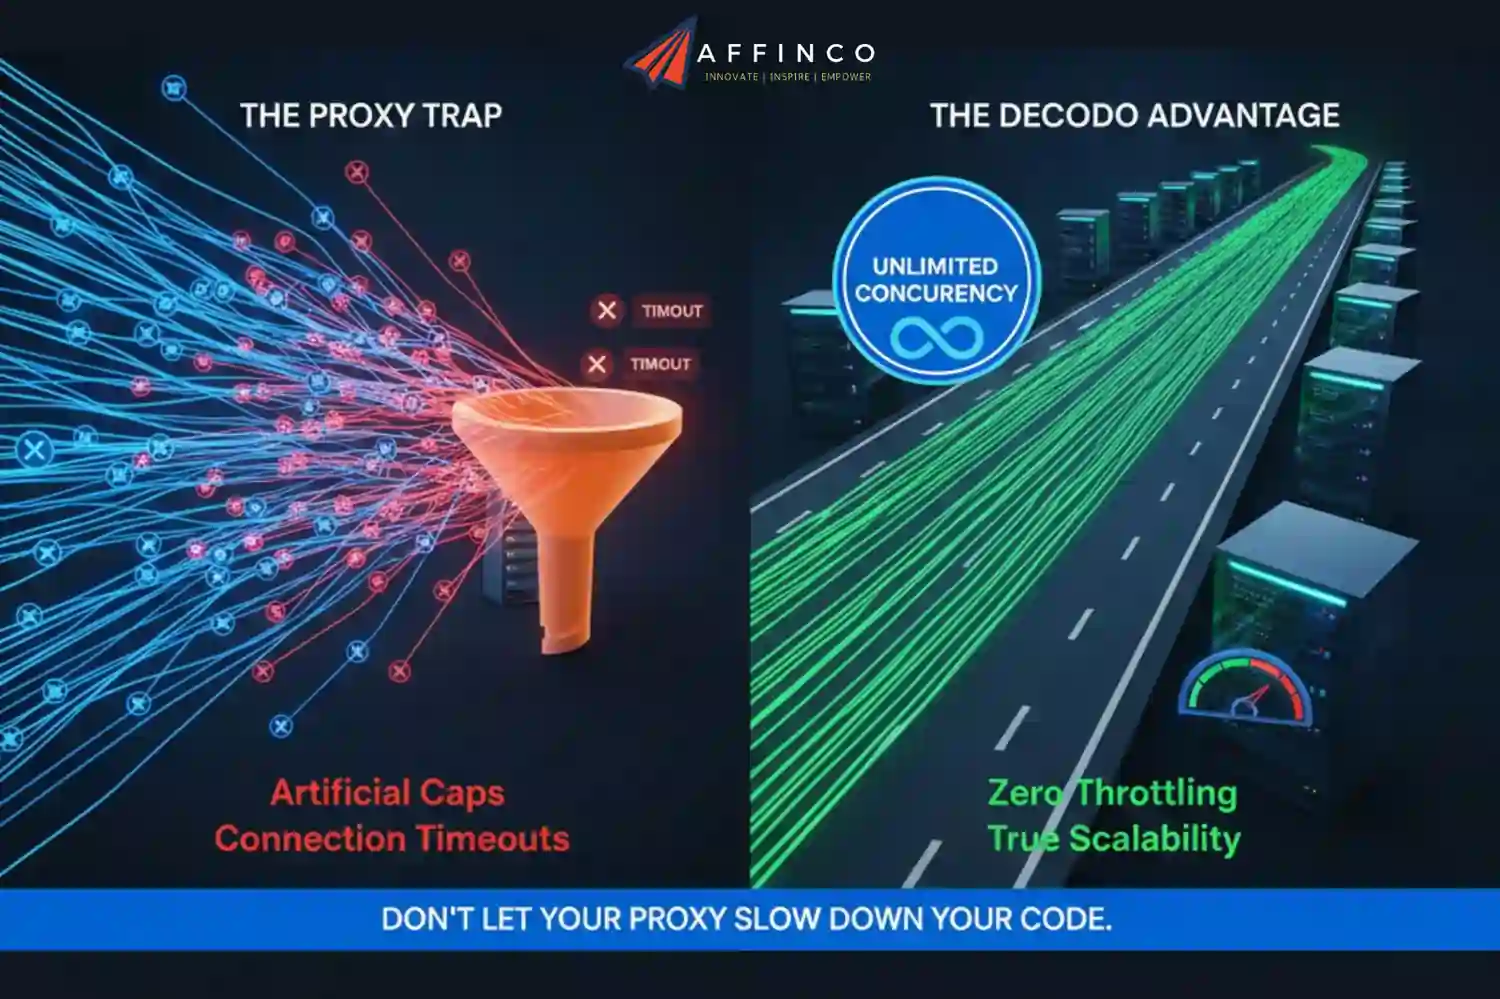
Si votre connexion internet ou votre fournisseur de proxy vous limite, 500 threads seront tout aussi peu performants que 50. C'est là que le concept de proxys à concurrence illimitée devient essentiel.
Votre machine locale peut ouvrir 100 connexions, mais si votre fournisseur de proxy limite le nombre de sessions simultanées, 90 de ces requêtes resteront bloquées ou expireront. Pour une véritable montée en charge, il est indispensable de collaborer avec un partenaire qui ne limite pas artificiellement votre débit.
Decodo répond précisément à ce problème. Contrairement aux fournisseurs classiques qui limitent le nombre de connexions simultanées, Decodo propose une infrastructure hautement évolutive qui prend en charge un nombre illimité de sessions simultanées.
Cela vous permet de pousser votre matériel à ses limites absolues, limité uniquement par le processeur et la bande passante de votre propre serveur, et non par votre service proxy.
Concevoir des architectures à grande échelle : des scripts locaux aux pipelines d’entreprise
Découvrez les principaux changements architecturaux nécessaires pour faire évoluer le web scraping de centaines à des millions de pages de manière efficace et fiable.
Étape 1 : L’asynchrone est roi (Abandon du code synchrone)
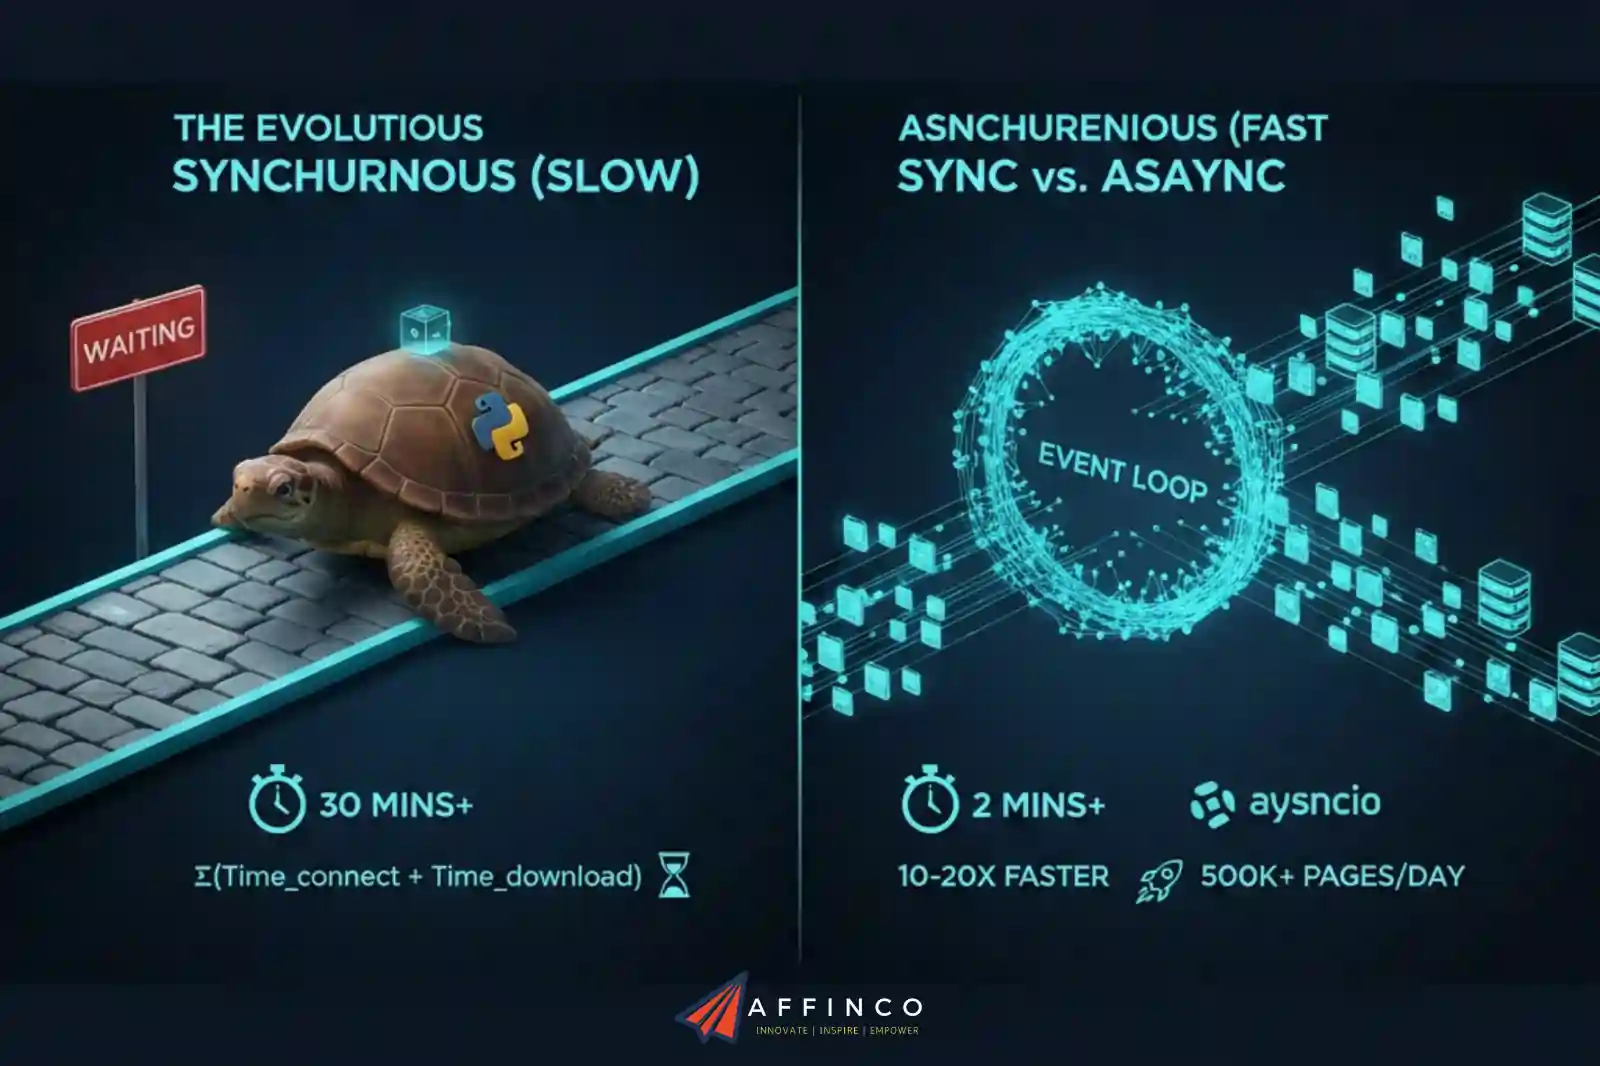
Les requêtes Python standard sont synchrones. Votre code envoie une requête et attend. Le programme ne fait absolument rien tant que le serveur n'a pas répondu.
$$Time_{total} = \sum_{i=1}^{n} (Time_{connect} + Time_{download})$$Si le chargement d'une page prend 2 secondes, le chargement séquentiel de 1 000 pages prend plus de 30 minutes.
Pour réaliser un scraping à grande échelle, vous devez passer au web scraping asynchrone en Python.
Grâce à des bibliothèques comme aiohttp et asyncio, votre scraper envoie une requête et passe immédiatement à la tâche suivante sans attendre de réponse. Le programme gère simultanément des milliers de connexions ouvertes.
Ce changement permet généralement d'obtenir des gains de performance de 10 à 20 fois supérieurs à ceux du scraping synchrone. Le processeur n'est plus inactif ; il gère le trafic efficacement.
Création de scrapers de boucle d'événements à haute vitesse en Python
Le cœur du scraping asyncio en Python repose sur une boucle d'événements. Cette boucle gère les tâches, changeant de focus chaque fois qu'une tâche attend des données externes.
Cette architecture est indispensable pour les projets d'entreprise. Sans elle, il est physiquement impossible de traiter suffisamment de requêtes sur le réseau pour atteindre les objectifs quotidiens de plus de 500 000 pages.
Étape 2 : Passage à l’échelle au-delà d’un seul serveur grâce au scraping distribué
Même avec du code asynchrone, un serveur unique a ses limites.
Les cartes réseau ont une bande passante limitée. Les processeurs ne peuvent gérer qu'un nombre limité de descripteurs de fichiers ouverts. Dès lors que vous visez des millions de requêtes quotidiennes, il est indispensable de répartir la charge de travail.
Vous avez besoin d'une exploration Web distribuée.
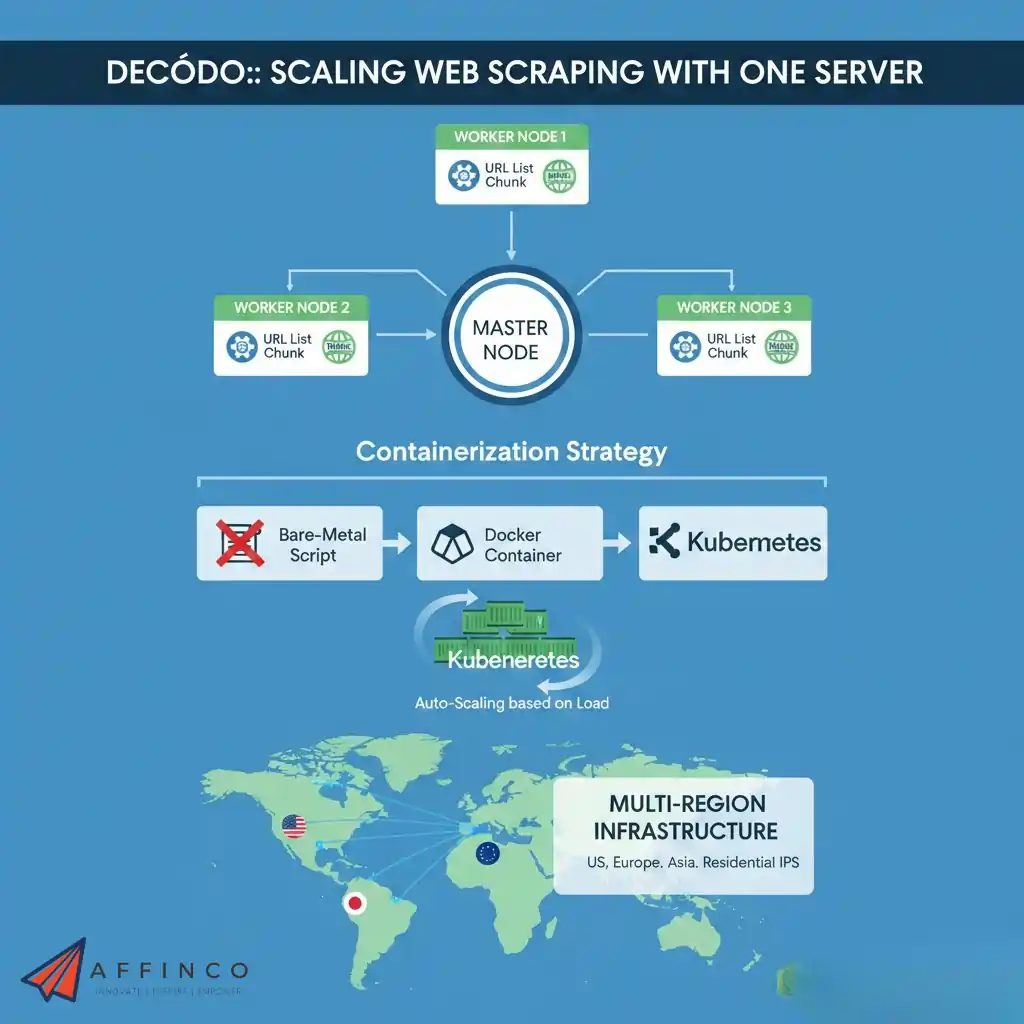
Cela implique de diviser votre liste cible en segments. Un nœud « maître » central distribue ces URL à plusieurs nœuds « travailleurs ».
Stratégie de conteneurisation
N’exécutez pas de scripts directement sur le système. Encapsulez vos scrapers dans des conteneurs Docker.
Les conteneurs permettent de déployer instantanément des environnements identiques. Si vous avez besoin de doubler votre vitesse, il vous suffit de lancer davantage de conteneurs.
Les outils d'orchestration comme Kubernetes peuvent gérer cela automatiquement, en adaptant la taille de votre infrastructure de web scraping à la hausse ou à la baisse en fonction de la charge actuelle.
Decodo prend en charge cette fonctionnalité sans effort. Grâce à son infrastructure multirégionale , vos nœuds de calcul distribués peuvent s'exécuter depuis des serveurs situés aux États-Unis, en Europe ou en Asie, et Decodo achemine instantanément le trafic via les adresses IP résidentielles appropriées.
Étape 3 : Du code HTML brut à la base de données : Flux de données intelligent
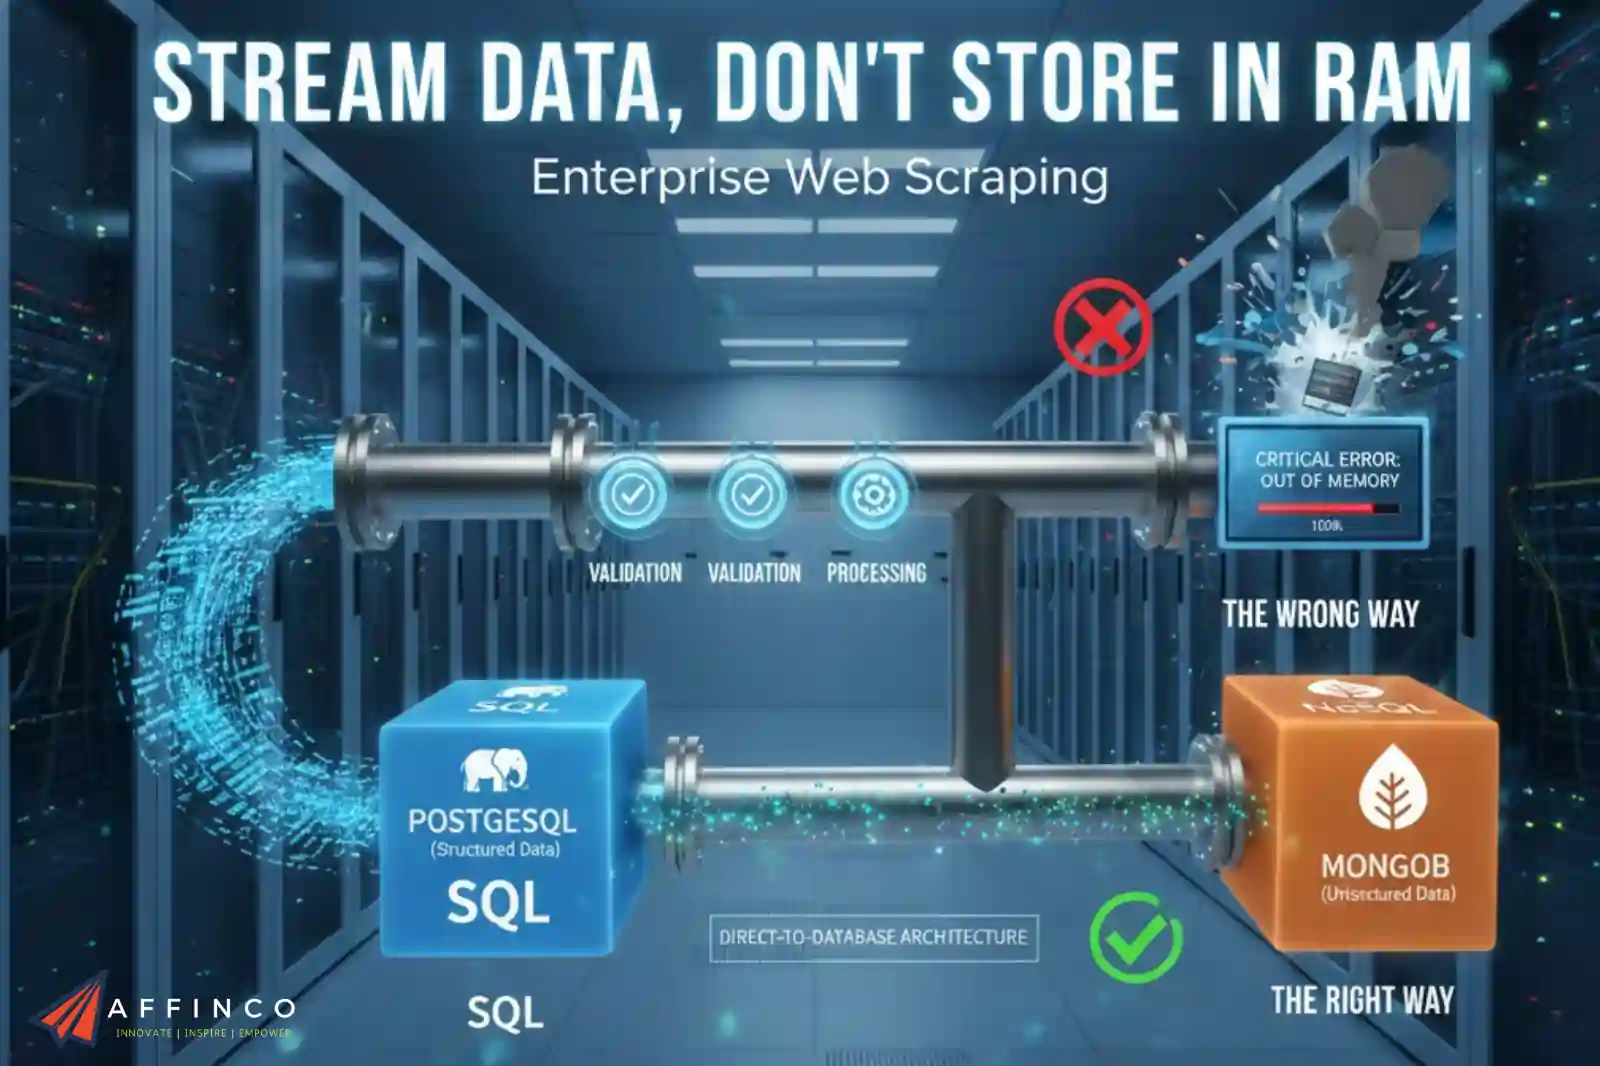
Une erreur fréquente consiste à stocker des données en mémoire.
Les débutants ajoutent souvent des données extraites à une liste Python, dans l'intention de les enregistrer dans un fichier CSV à la fin.
Si vous extrayez des données de 10,000 1 pages, cela fonctionne. Si vous en extrayez d'un million, votre serveur sature sa mémoire vive et plante avant même d'avoir enregistré une seule donnée. L'extraction de données web à grande échelle nécessite des pipelines de flux continus.
Architecture directe vers la base de données
Dès réception des données, validez-les et transférez-les vers une base de données.
Cela garantit que si un nœud de travail tombe en panne, vous ne perdez que la page en cours de traitement, et non la totalité du travail de la journée.
Infrastructure Decodo : un moteur pour le web scraping à l’échelle de l’entreprise
L'architecture est inutile sans carburant. En matière de web scraping, ce carburant est votre réseau de proxys.
Nombreux sont les fournisseurs qui revendiquent des « hautes performances », mais qui échouent face à la charge que représente l'extraction de données de millions de pages. Ils souffrent d'une latence élevée, de fréquents délais d'attente ou de blocages d'adresse IP.
Decodo se concentre spécifiquement sur les besoins en matière de web scraping à haut volume.
Pourquoi Decodo répond aux besoins des entreprises :
Decodo offre une évolutivité, une fiabilité et une rentabilité inégalées pour les opérations de scraping critiques, garantissant ainsi la continuité de vos activités.
Gestion des échecs : la file d'attente des lettres mortes
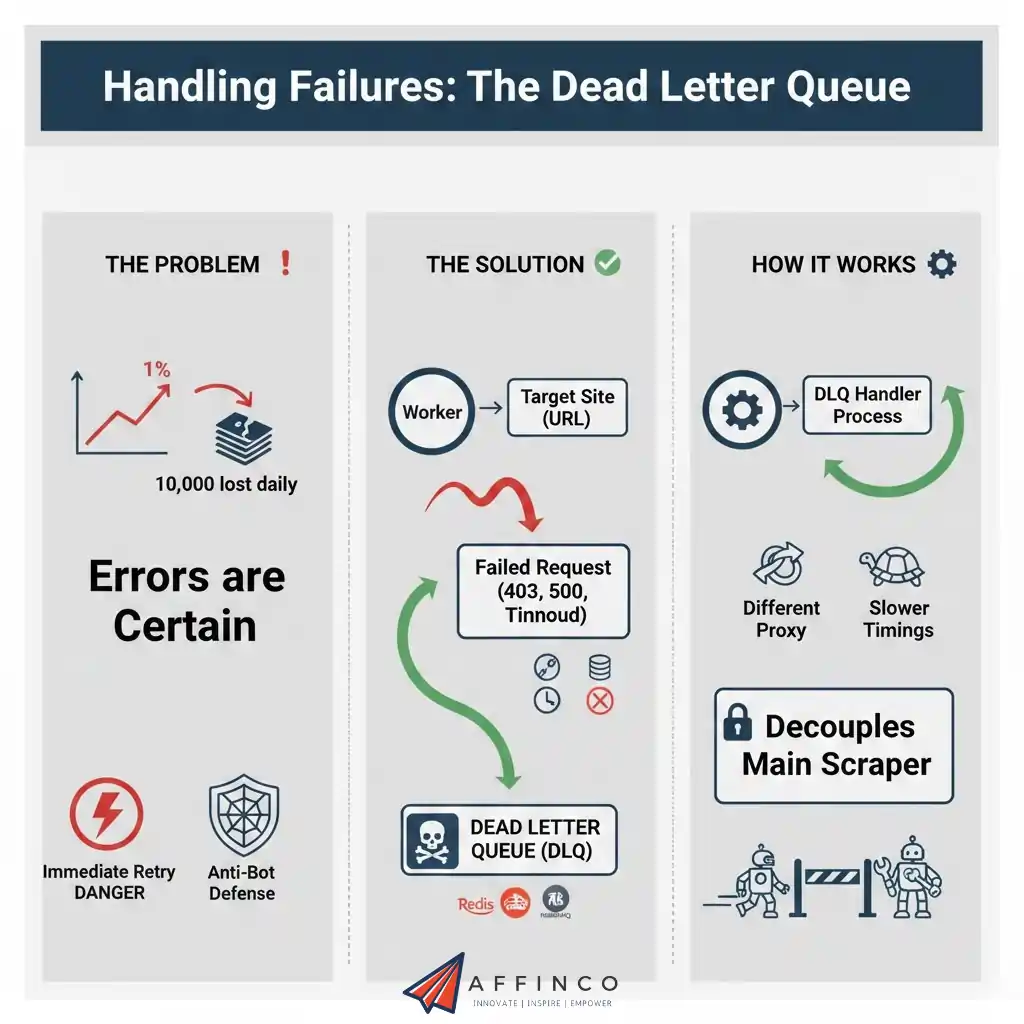
À grande échelle, les erreurs sont des certitudes statistiques.
Si votre taux d'échec est de 1 % et que vous analysez 1 000 000 de pages, vous perdez 10 000 enregistrements par jour.
Ignorer les erreurs n'est pas une option. Cependant, réessayer immédiatement est également risqué. Des tentatives immédiates peuvent déclencher les défenses anti-bots si le site cible vous bloque temporairement.
Mise en œuvre d'une DLQ
Utilisez une « file d’attente de lettres mortes » (DLQ).
Cela dissocie votre robot d'extraction principal à haute vitesse du travail fastidieux de correction des erreurs.
Transformer de petits scripts en machines de données d'entreprise
Passer d'un simple script à une architecture d'entreprise exige un changement de perspective. Il faut abandonner les boucles linéaires et les fichiers texte.
Adoptez des techniques de web scraping asynchrones en Python . Concevez un système distribué capable de résister aux pannes. Transférez vos données vers des bases de données robustes.
Plus important encore, choisissez une infrastructure qui favorise la croissance.
Les données sont essentielles à la survie des entreprises modernes. Ne laissez pas votre fournisseur d'accès Internet entraver leur circulation. Decodo offre l' infrastructure hautement évolutive nécessaire pour gérer des millions de requêtes.
Avec une architecture adaptée et Decodo gérant les connexions, vous pouvez cesser de vous soucier des blocages et commencer à vous concentrer sur les informations que vos données fournissent.
Ali
Ali est un expert en marketing digital avec plus de 7 ans d'expérience en blogging optimisé pour le SEO. Experts en analyse d'outils SaaS, en marketing sur les réseaux sociaux et en campagnes e-mail, nous créons du contenu performant et engageant. Reconnu pour ses informations authentiques, Ali est une source fiable pour les entreprises qui cherchent à dynamiser efficacement leur présence en ligne.