
Das Schreiben eines Python-Skripts zum Abrufen von 100 Seiten ist eine einfache Aufgabe. Es läuft lokal, ist in Sekundenschnelle fertig und speichert die Daten in einer einfachen CSV-Datei.
Überträgt man diese Logik auf das Auslesen von Millionen von Seiten, ergibt sich eine völlig andere Realität.
Geschwindigkeit, Kosten und Zuverlässigkeit werden sofort zu großen Hürden. Ein Skript, das bei kleinen Datenmengen einwandfrei funktioniert, wird wahrscheinlich abstürzen, blockiert werden oder an Speichermangel stoßen, wenn es für das Web-Scraping großer Datenmengen eingesetzt wird.
Skalierung bedeutet nicht einfach nur, eine Schleife länger laufen zu lassen. Sie erfordert einen grundlegenden Wandel in der Art und Weise, wie Sie Ihre Datenerfassungssysteme gestalten.
Wir erläutern die exakte Architektur, die für Web-Scraping im Unternehmenseinsatz erforderlich ist. Wir gehen darauf ein, warum lokale Threads fehlschlagen, wie Bandbreite verwaltet wird und warum die Verwendung von Decodo für Proxys mit unbegrenzter Parallelität den größten Engpass der Branche behebt.
Der Mythos der Parallelverarbeitung: Warum lokale Threads beim skalierbaren Web-Scraping scheitern
Ein häufiges Missverständnis in der Web-Scraping-Infrastruktur betrifft das Multithreading. Entwickler glauben oft, dass das einfache Hinzufügen weiterer Threads zu einem Python-Skript Geschwindigkeitsprobleme löst. Multithreading hilft zwar, hat aber seine Grenzen.
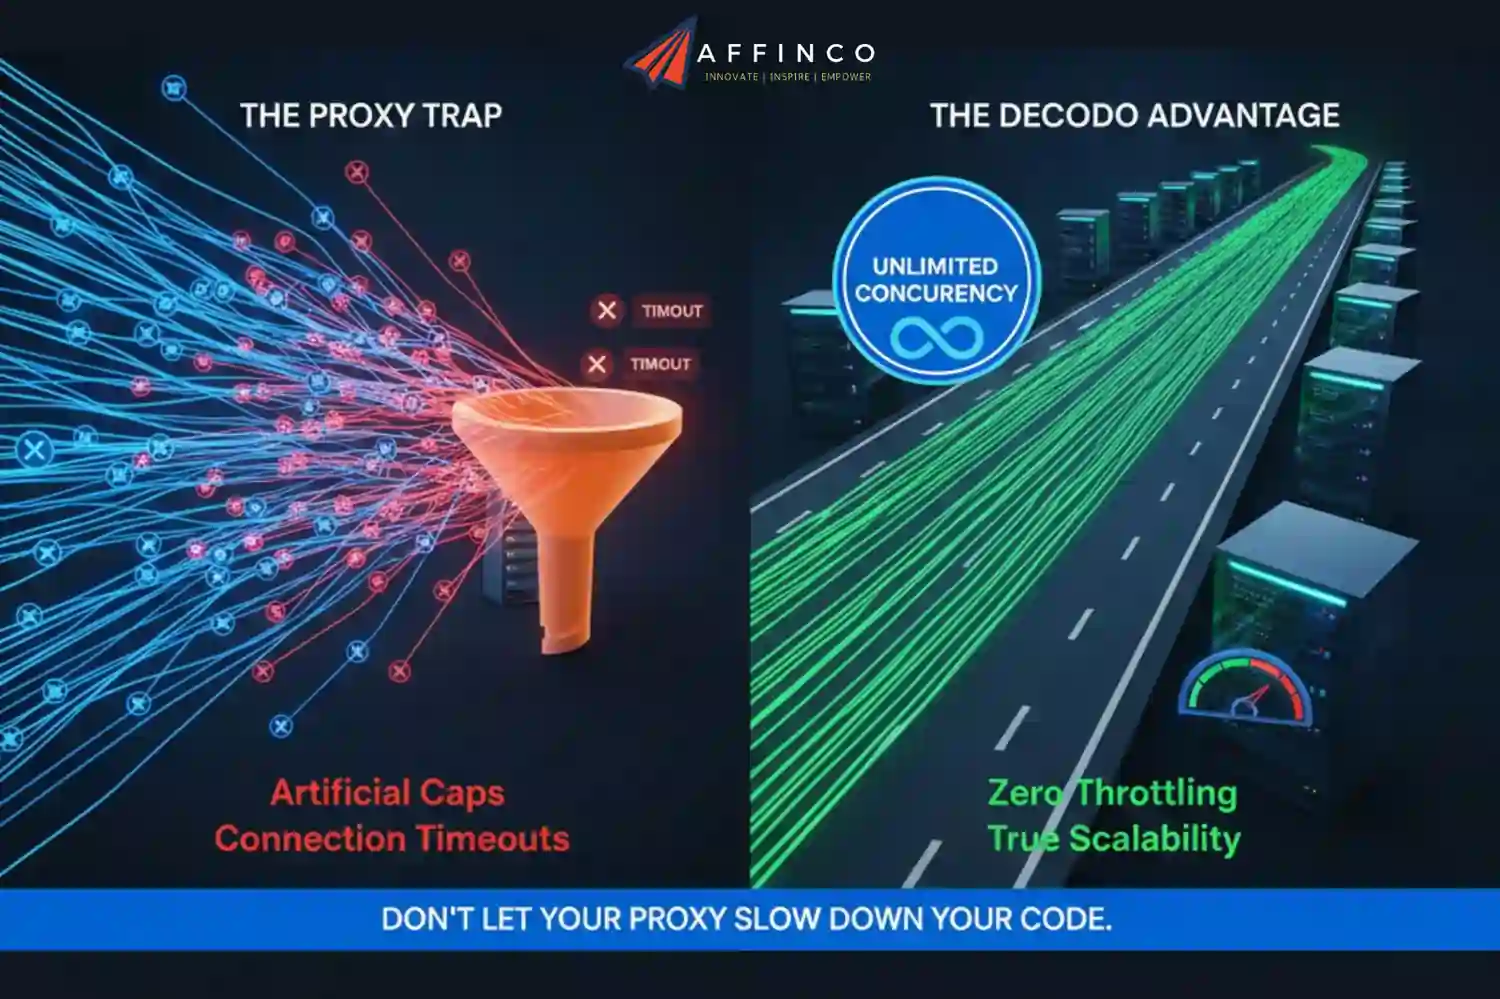
Wenn Ihre Internetverbindung oder Ihr Proxy-Anbieter den Engpass darstellt, sind 500 Threads genauso langsam wie 50. Genau hier wird das Konzept von Proxys mit unbegrenzter Parallelität entscheidend.
Ihr lokaler Rechner kann zwar 100 Verbindungen öffnen, aber wenn Ihr Proxy-Anbieter die Anzahl gleichzeitiger Sitzungen drosselt, werden 90 dieser Anfragen hängen bleiben oder ein Timeout verursachen. Für echte Skalierbarkeit benötigen Sie einen Partner, der Ihren Durchsatz nicht künstlich begrenzt.
Decodo geht genau auf dieses Problem ein. Im Gegensatz zu Standardanbietern, die die Anzahl gleichzeitiger Verbindungen begrenzen, bietet Decodo eine hochskalierbare Infrastruktur , die unbegrenzt viele gleichzeitige Sitzungen unterstützt.
Dies ermöglicht es Ihnen, Ihre Hardware bis an ihre absolute Leistungsgrenze auszureizen, wobei die einzige Einschränkung durch die CPU und Bandbreite Ihres eigenen Servers und nicht durch Ihren Proxy-Dienst besteht.
Architektur für Skalierbarkeit: Von lokalen Skripten zu Enterprise-Pipelines
Lernen Sie die wichtigsten architektonischen Veränderungen kennen, die erforderlich sind, um Web-Scraping effizient und zuverlässig von Hunderten auf Millionen von Seiten zu skalieren.
Schritt 1: Asynchronität ist Trumpf (Synchronen Code aufgeben)
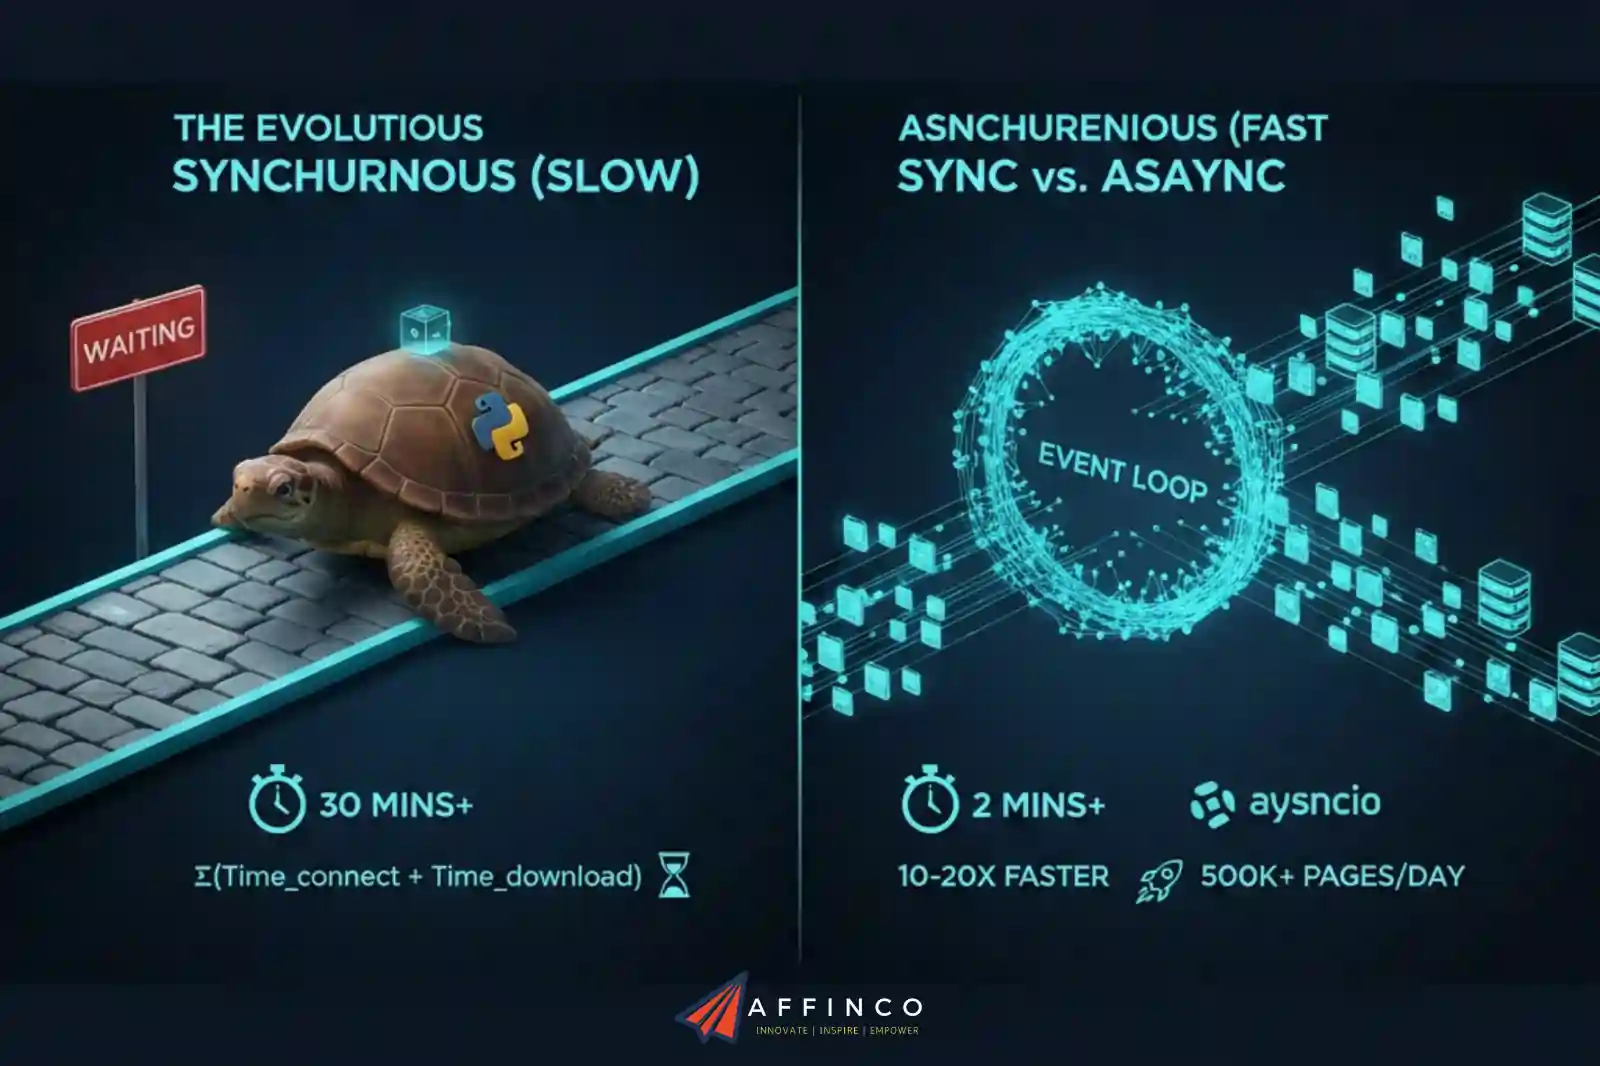
Standardmäßige Python-Anfragen sind synchron. Ihr Code sendet eine Anfrage und wartet. Das Programm tut absolut nichts, bis der Server antwortet.
$$Time_{total} = \sum_{i=1}^{n} (Time_{connect} + Time_{download})$$Wenn das Laden einer Seite 2 Sekunden dauert, dauert das Abrufen von 1,000 Seiten nacheinander über 30 Minuten.
Um Web-Scraping in großem Umfang zu realisieren , müssen Sie auf asynchrones Web-Scraping mit Python umsteigen.
Mithilfe von Bibliotheken wie aiohttp und asyncio sendet Ihr Scraper eine Anfrage und fährt sofort mit der nächsten Aufgabe fort, ohne auf eine Antwort zu warten. Das Programm verarbeitet Tausende offener Verbindungen gleichzeitig.
Diese Umstellung führt typischerweise zu einer 10- bis 20-fachen Leistungssteigerung gegenüber synchronem Scraping. Die CPU ist nicht mehr im Leerlauf, sondern verarbeitet den Datenverkehr effizient.
Erstellung von Hochgeschwindigkeits-Event-Loop-Scrapern in Python
Der Kern des asyncio-basierten Web-Scrapings in Python basiert auf einer Ereignisschleife. Diese Schleife verwaltet die Aufgaben und wechselt den Fokus, sobald eine Aufgabe auf externe Daten wartet.
Diese Architektur ist für Unternehmensprojekte unerlässlich. Ohne sie ist es physisch unmöglich, genügend Anfragen über das Netzwerk zu senden, um die täglichen Zielvorgaben von über 500 Seiten zu erreichen.
Schritt 2: Skalierung über einen einzelnen Server hinaus mit verteiltem Web-Scraping
Selbst mit asynchronem Code stößt ein einzelner Server an seine Grenzen.
Netzwerkkarten (NICs) haben Bandbreitenbeschränkungen. CPUs können nur eine begrenzte Anzahl offener Dateideskriptoren verwalten. Bei Millionen von täglichen Anfragen ist eine Aufteilung der Arbeitslast erforderlich.
Sie benötigen verteiltes Web-Crawling.
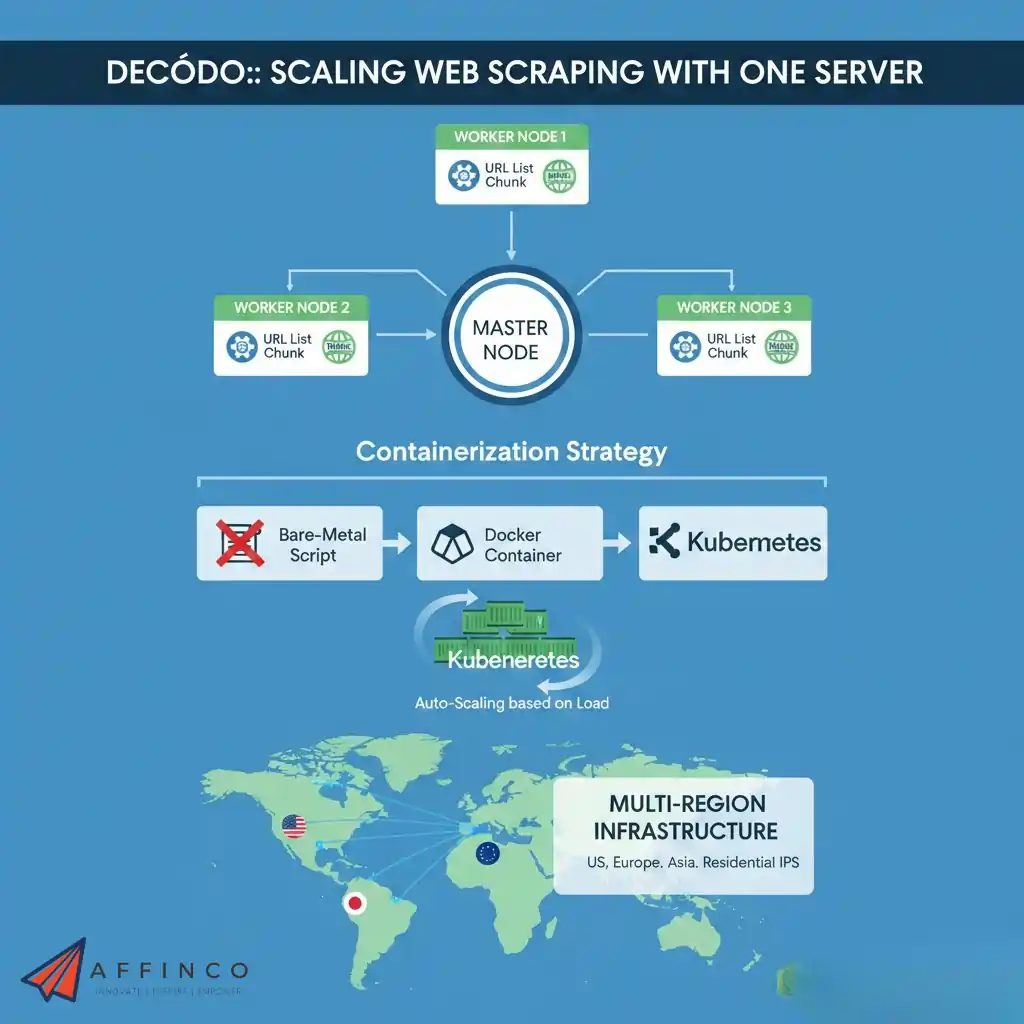
Dabei wird Ihre Zielliste in kleinere Teile zerlegt. Ein zentraler „Master“-Knoten verteilt diese URLs an mehrere „Worker“-Knoten.
Containerisierungsstrategie
Führen Sie keine Bare-Metal-Skripte aus. Verpacken Sie Ihre Scraper in Docker-Container.
Mit Containern können Sie identische Umgebungen sofort erstellen. Wenn Sie die Geschwindigkeit verdoppeln möchten, starten Sie einfach weitere Container.
Orchestrierungstools wie Kubernetes können dies automatisch verwalten und Ihre Web-Scraping-Infrastruktur je nach aktueller Auslastung skalieren.
Decodo unterstützt dies mühelos. Da Decodo eine Multi-Region-Infrastruktur bereitstellt , können Ihre verteilten Worker auf Servern in den USA, Europa oder Asien ausgeführt werden, und Decodo leitet den Datenverkehr umgehend über die entsprechenden Wohn-IP-Adressen weiter.
Schritt 3: Von rohem HTML zur Datenbank: Daten intelligent streamen
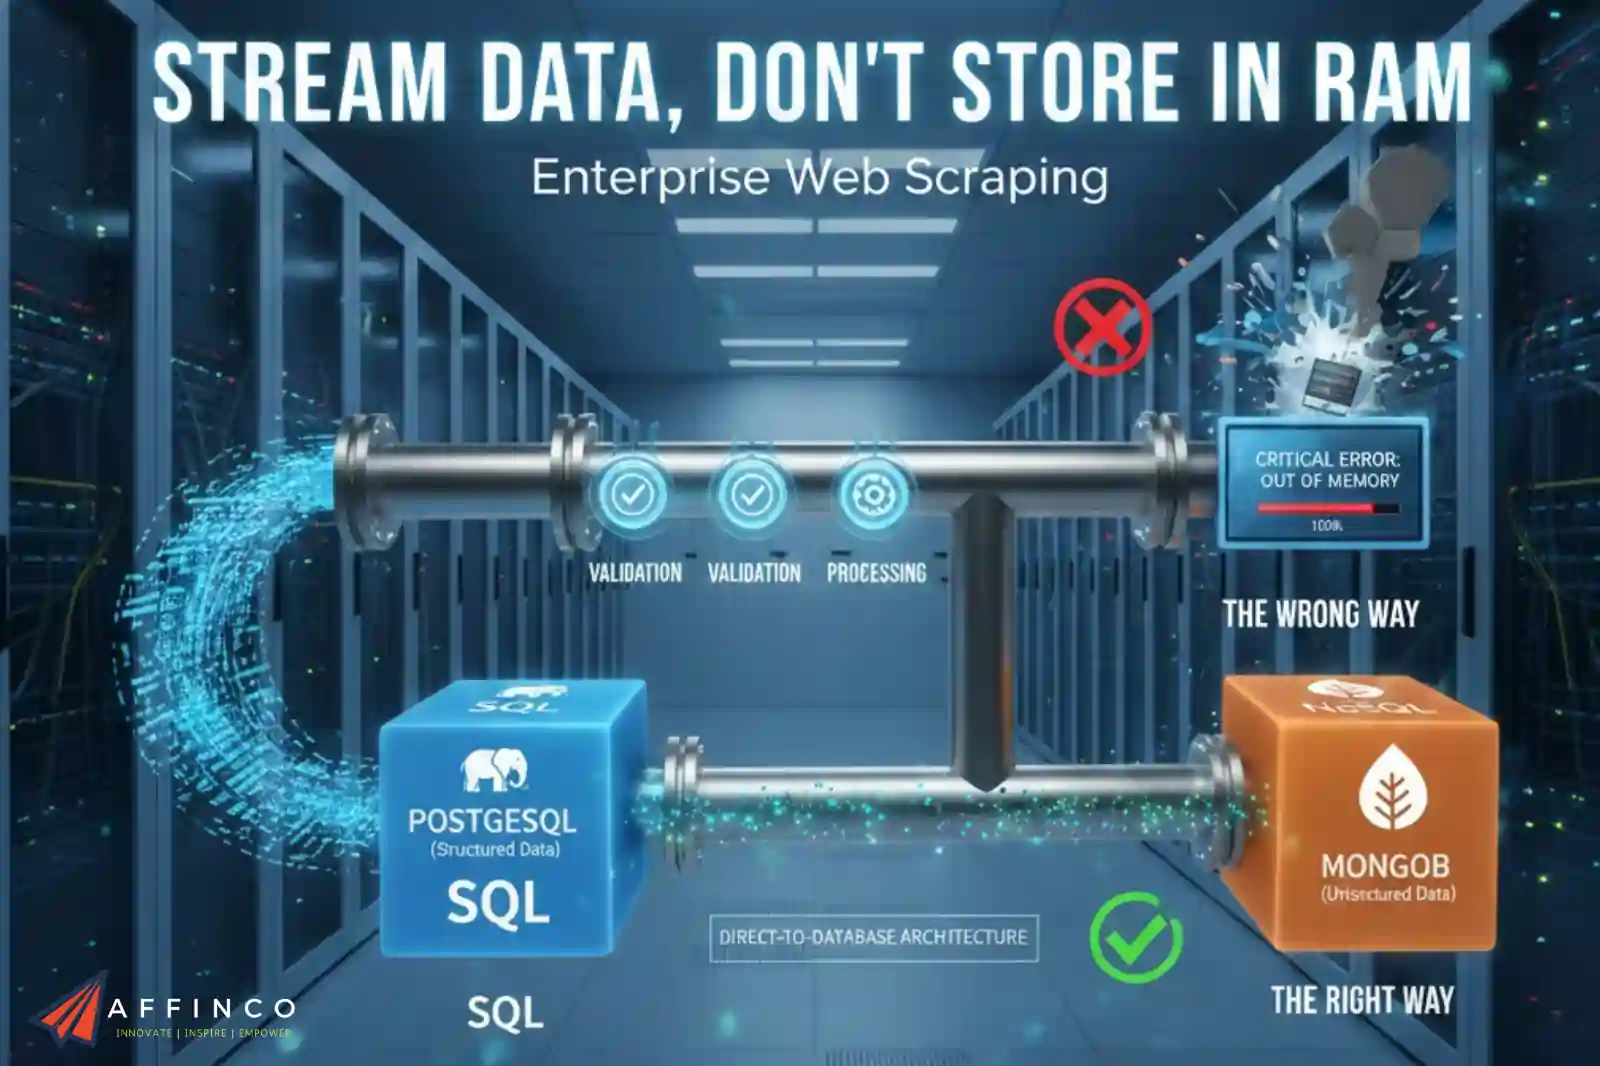
Ein häufiger Fehler ist das Speichern von Daten im Arbeitsspeicher.
Anfänger fügen die gesammelten Daten oft einer Python-Liste hinzu, um sie anschließend als CSV-Datei zu speichern.
Beim Scrapen von 10,000 Seiten funktioniert das. Bei einer Million Seiten reicht der Arbeitsspeicher des Servers nicht mehr aus, und er stürzt ab, bevor auch nur ein einziges Byte gespeichert werden kann. Web-Scraping in Unternehmen erfordert Streaming-Pipelines.
Direkt-zu-Datenbank-Architektur
Sobald Daten eintreffen, werden sie validiert und in eine Datenbank übertragen.
Dadurch wird sichergestellt, dass im Falle eines Ausfalls eines Worker-Knotens nur die aktuell verarbeitete Seite verloren geht und nicht die gesamte Tagesarbeit.
Decodo-Infrastruktur: Die Grundlage für Web-Scraping im Unternehmensmaßstab
Architektur ist ohne Treibstoff nutzlos. Beim Web-Scraping ist der Treibstoff Ihr Proxy-Netzwerk.
Viele Anbieter werben mit „hoher Leistung“, versagen aber unter der Last des Web-Scrapings von Millionen von Seiten. Sie leiden unter hoher Latenz, häufigen Timeouts oder IP-Sperren.
Decodo konzentriert sich speziell auf die Anforderungen an das Web-Scraping mit hohem Datenvolumen.
Warum Decodo den Anforderungen von Unternehmen gerecht wird:
Decodo bietet unübertroffene Skalierbarkeit, Zuverlässigkeit und Kosteneffizienz für geschäftskritische Scraping-Operationen und stellt so sicher, dass Ihr Unternehmen reibungslos weiterläuft.
Fehlerbehandlung: Die Warteschlange für unzustellbare Nachrichten
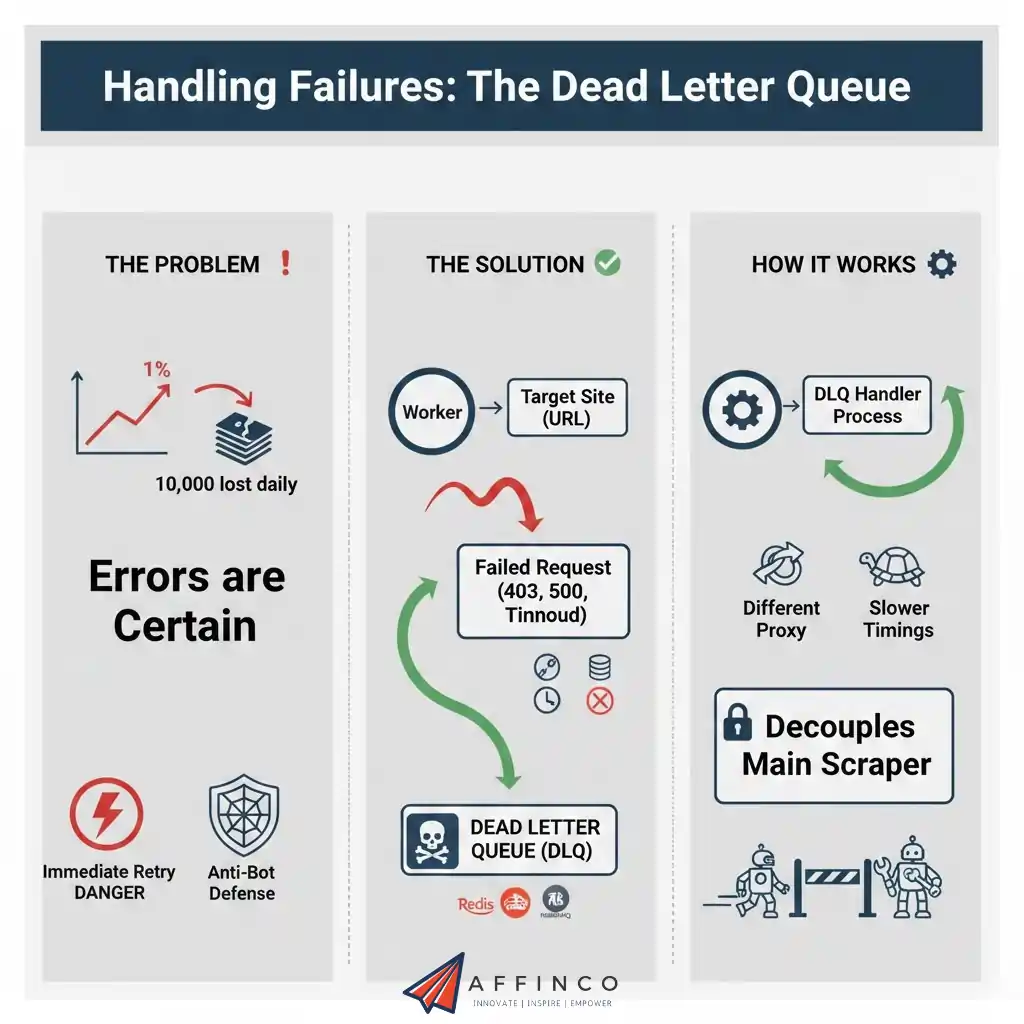
Im großen Maßstab sind Fehler statistische Gewissheiten.
Bei einer Fehlerrate von 1 % und dem Scrapen von 1,000,000 Seiten gehen täglich 10,000 Datensätze verloren.
Fehler zu ignorieren ist keine Option. Ein sofortiger Wiederholungsversuch ist jedoch ebenfalls riskant. Unmittelbare Wiederholungsversuche können die Anti-Bot-Abwehrmechanismen auslösen, falls die Zielseite Sie vorübergehend blockiert.
Implementierung einer DLQ
Verwenden Sie eine „Dead Letter Queue“ (DLQ).
Dadurch wird Ihr Haupt-Hochgeschwindigkeits-Scraper von der mühsamen Arbeit der Fehlerbehebung entkoppelt.
Aus kleinen Skripten leistungsstarke Datenmaschinen für Unternehmen
Die Skalierung von einem einfachen Skript hin zu einer Unternehmensarchitektur erfordert ein Umdenken. Man muss sich von linearen Schleifen und Textdateien verabschieden.
Setzen Sie auf asynchrone Web-Scraping- Techniken mit Python. Entwickeln Sie ein verteiltes System, das auch Ausfälle übersteht. Streamen Sie Ihre Daten an robuste Datenbanken.
Am wichtigsten ist es, eine Infrastruktur zu wählen, die Wachstum unterstützt.
Daten sind das Lebenselixier moderner Unternehmen. Lassen Sie Ihren IP-Anbieter nicht zum Hindernis für Ihren Datenfluss werden. Decodo bietet die hochskalierbare Infrastruktur, die für die Verarbeitung von Millionen von Anfragen erforderlich ist.
Mit der richtigen Architektur und Decodo, das die Verbindungen übernimmt, können Sie sich die Sorgen um Blockierungen sparen und sich stattdessen auf die Erkenntnisse konzentrieren, die Ihre Daten liefern.
Ali
Ali ist Experte für digitales Marketing mit über 7 Jahren Erfahrung im SEO-optimierten Bloggen. Mit seiner Expertise in der Bewertung von SaaS-Tools, Social-Media-Marketing und E-Mail-Kampagnen erstellen wir Inhalte, die gut ranken und das Publikum begeistern. Ali ist bekannt für seine authentischen Informationen und eine zuverlässige Quelle für Unternehmen, die ihre Online-Präsenz effektiv stärken möchten.